Pro
R$ 129,90/mês
- 4 vCore Processador
- 6 GB Memória
- NVME 120 GB Disco
- Ilimitado Tráfego
 IA e agentes · Rio de Janeiro ou São Paulo
Rode uma IA própria no seu VPS: o Ollama executa o modelo Qwen 3.5 e o Open WebUI entrega um chat no navegador, com login e HTTPS. Sem chave de API, sem cobrança por mensagem e com as conversas guardadas no seu servidor.
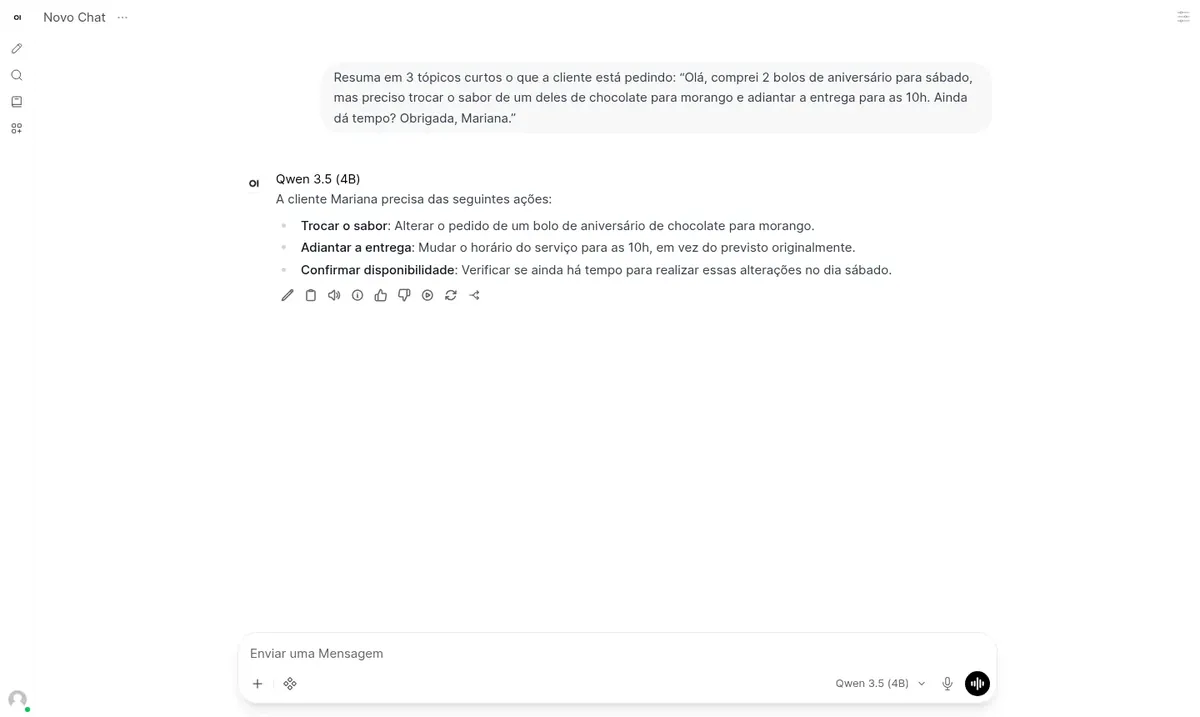
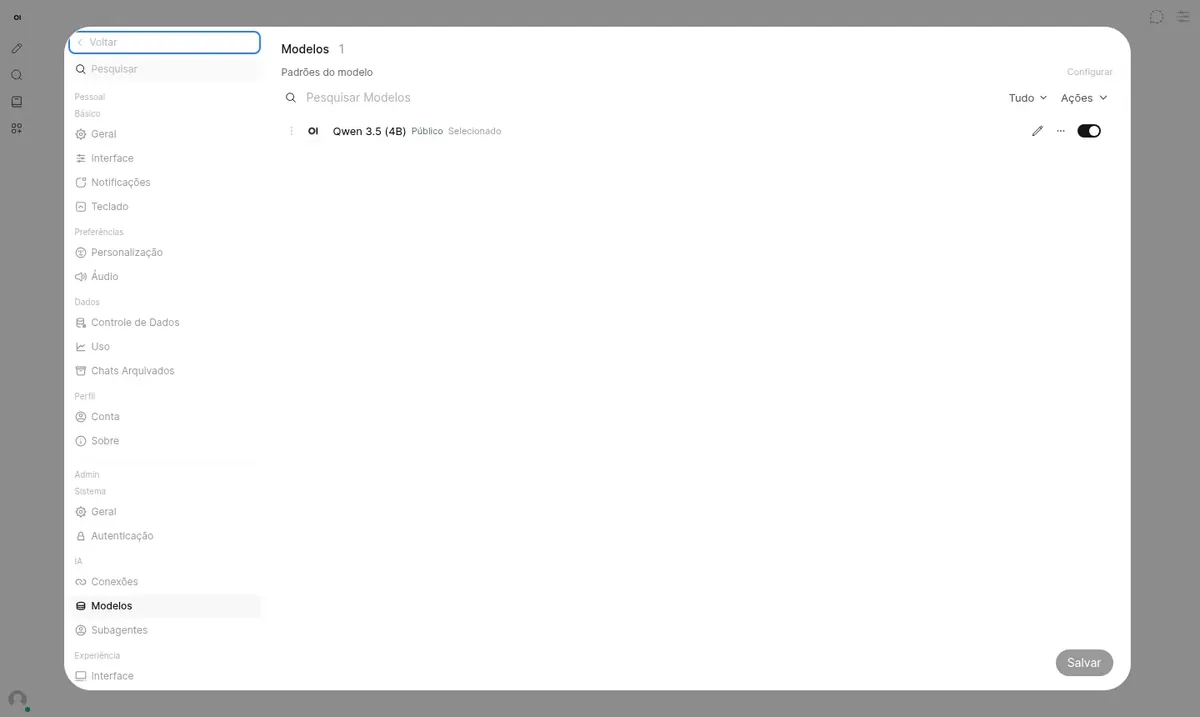
Modelo de linguagem consome bastante memória e processador. O conjunto com o Qwen 3.5 (4B) pede a partir de 5120 MB livres; o plano Plus é o que recomendamos para começar e o Pro dá mais folga.
Cobrança mensal, em reais, com o app instalado. Semestral e anual com desconto no pedido. Rio de Janeiro ou São Paulo, mesmo preço. Os planos começam no menor tamanho em que o app roda bem; precisa de mais? O upgrade é feito pela área do cliente, sem reinstalar.
Com a praça Rio de Janeiro, o seu VPS com Ollama e Open WebUI fica no data center original da Mega, em rede própria com saída no PTT Rio e trânsito redundante. É a menor latência para quem está no Rio, no Espírito Santo e em Minas, e a equipe de suporte trabalha na mesma praça do servidor.
Com a praça São Paulo, o seu VPS com Ollama e Open WebUI fica no nosso ambiente ao lado do ponto de troca de tráfego mais movimentado do país, com rede própria e trânsito redundante. É o caminho mais curto para usuários espalhados pelo Brasil e para integrações com bancos, gateways e APIs hospedadas em SP. Mesmo preço do Rio.
O Ollama é um programa de código aberto que executa modelos de linguagem (LLMs) no seu próprio servidor. Ele baixa o modelo, mantém na memória e responde por uma API, sem depender de OpenAI, Google ou outro serviço externo.
O Open WebUI é a interface de chat que fica na frente do Ollama. Ele guarda o histórico das conversas, aceita vários usuários, permite enviar documentos para a IA ler e troca de modelo com poucos cliques.
Este VPS não tem placa de vídeo, então todo o processamento acontece na CPU. Por isso o modelo escolhido é pequeno, o Qwen 3.5 com 4 bilhões de parâmetros. Ele atende bem em resumo, reescrita, classificação e rascunho, mas erra fatos com mais frequência do que os modelos gigantes da nuvem.
Fonte: Repositório oficial do Ollama no GitHub, consultado em outubro de 2026
Cole um e-mail, ata ou relatório e peça os pontos principais em tópicos.
Gere sugestões de resposta para clientes e ajuste o tom conforme o pedido.
Trabalhe com contratos e documentos internos sem enviá-los a terceiros.
Ferramentas como n8n podem consultar a API do Ollama quantas vezes precisar.
Separe solicitações por assunto ou retire campos específicos de um texto.
Baixe outros modelos da biblioteca do Ollama e veja qual se sai melhor no seu caso.
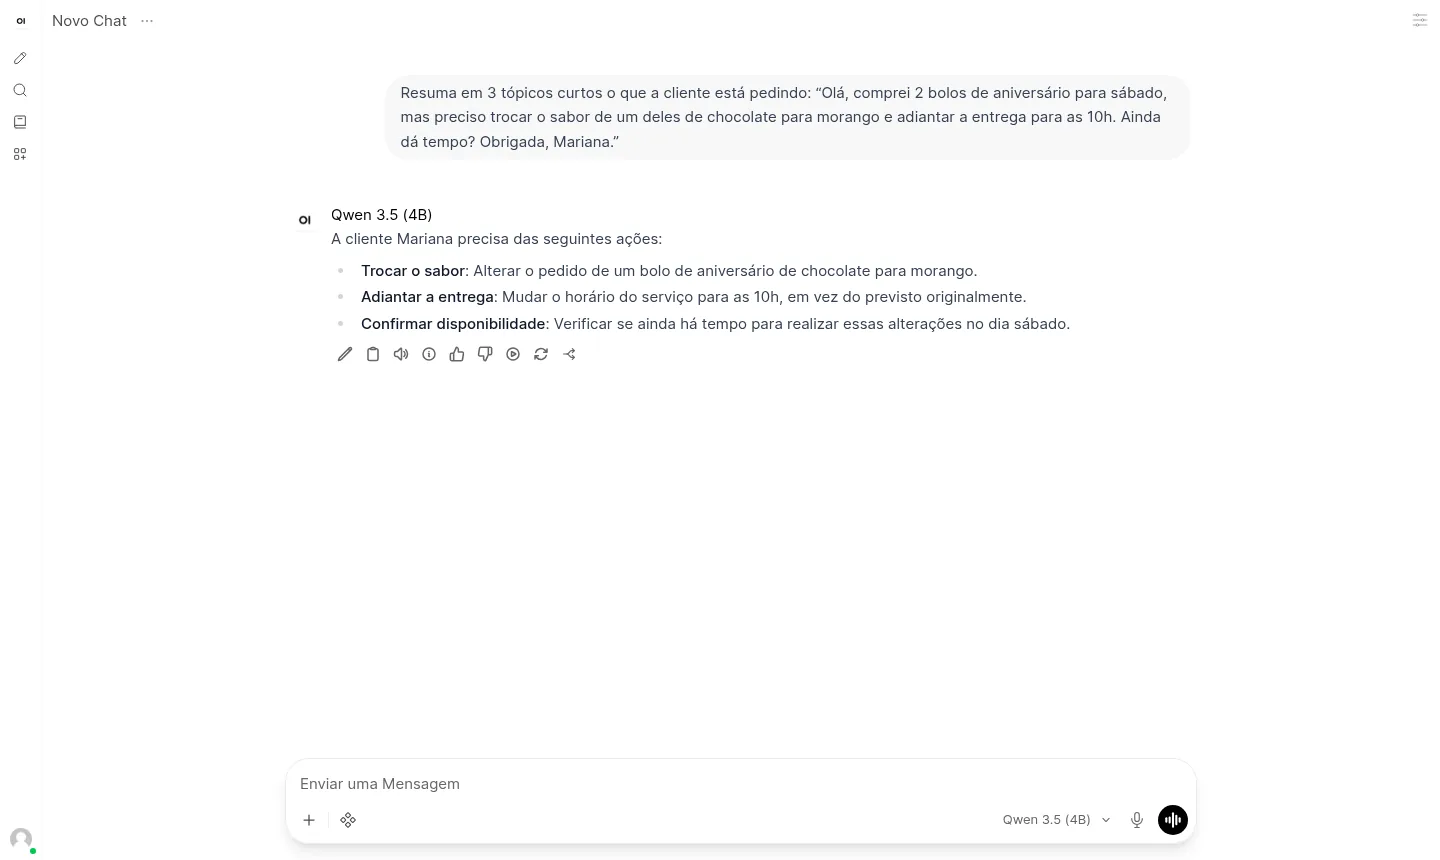
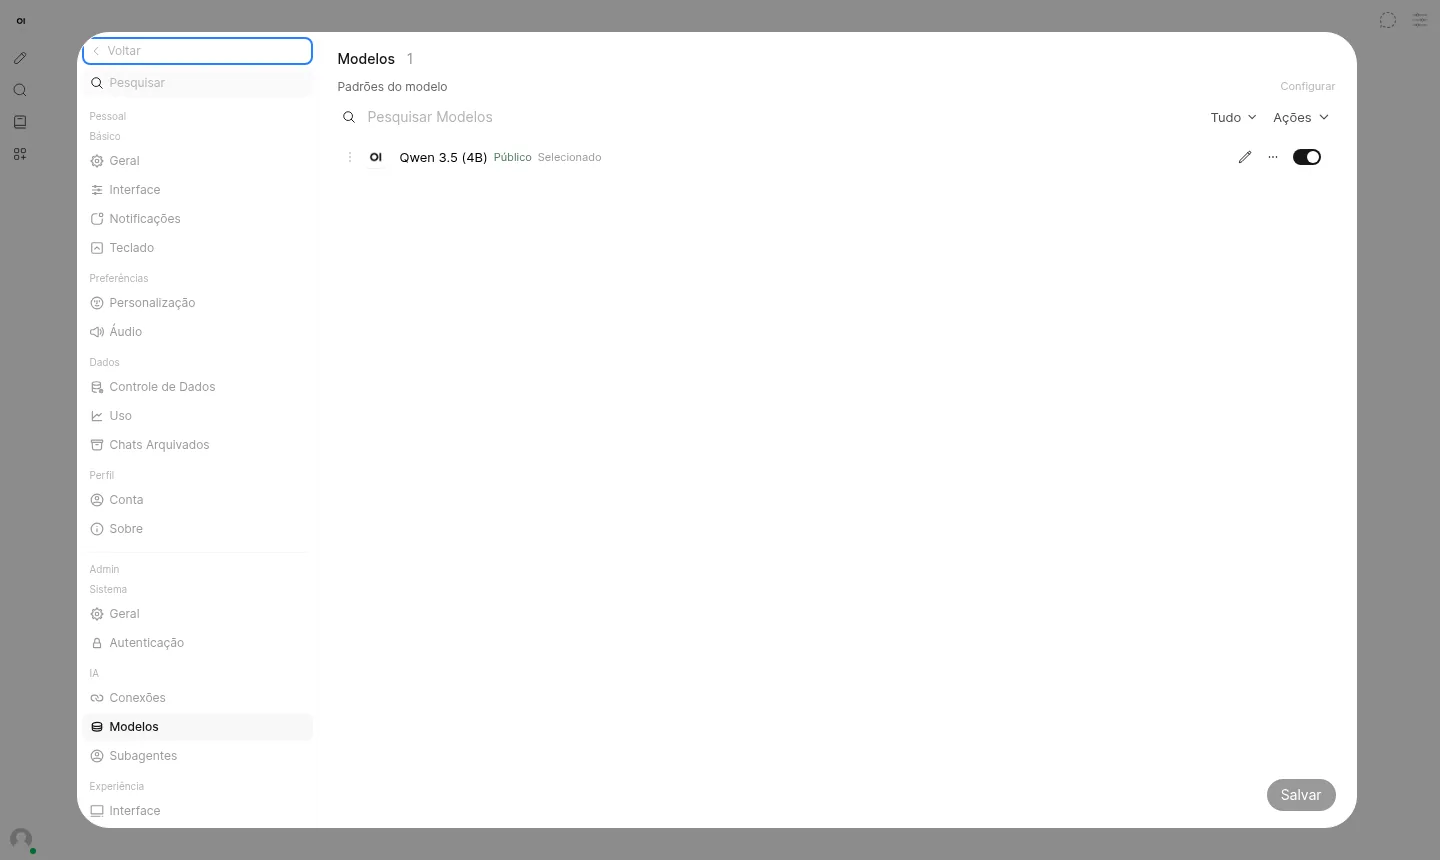
Prints feitos em uma instalação de teste da Mega Dedicados, com dados fictícios e sem nenhuma informação de cliente.
Versão fixa, com o modelo já carregado na memória para responder sem esperar a carga.
Modelo aberto com bom desempenho em português, baixado durante a instalação.
Chat no navegador, em português, com login e HTTPS no seu próprio endereço.
O modo de raciocínio vem desligado para que a CPU responda em menos tempo.
Títulos e sugestões automáticas desativados para não disputar processador com o chat.
O Ollama não fica exposto à internet; só o Open WebUI conversa com ele.
Selecione o Plus ou o Pro com o app Ollama e Open WebUI e defina se o VPS fica no Rio de Janeiro ou em São Paulo.
Pague com Pix, cartão ou boleto, em ciclo mensal, semestral ou anual. A instalação começa assim que o pagamento é confirmado.
O sistema cria o VPS, instala Ollama e Open WebUI e baixa o modelo, cerca de 13 GB no total. Nos nossos testes, levou de 5 a 15 minutos.
Endereço, login e senha chegam por e-mail e WhatsApp. Basta abrir o endereço no navegador e começar a conversar.
Comece pelo Turbo, o recomendado, que dá folga sobre os 5120 MB livres exigidos. O Pro funciona para testes, e Max ou Ultra servem quando houver mais usuários ou modelos maiores.
| Plano | Indicado para |
|---|---|
| Pro 4 vCore · 6 GB | Serve para testar sozinho o Qwen 3.5 (4B) com poucas conversas, rodando no limite da memória exigida. |
| Turbo 4 vCore · 12 GB | É o recomendado: dobra a memória do Pro, deixa folga para o sistema e atende bem uso pessoal diário. |
| Max 6 vCore · 18 GB | Indicado para quem divide o chat com família ou equipe pequena e quer mais folga de CPU e memória. |
| Ultra 8 vCore · 24 GB | Para uso intenso com várias pessoas ao mesmo tempo ou para testar modelos maiores com bastante margem de recursos. |
O VPS com os dois apps instalados parte de por mês no plano Plus, e o Pro custa R$ 129,90. Não existe cobrança por mensagem nem chave de API para contratar.
Não. O modelo que roda em servidor sem placa de vídeo é muito menor que os da nuvem. Ele funciona bem para resumir, rascunhar e classificar textos, mas pode inventar informações, então confira o que for crítico.
Em teste com 4 vCPUs e 6 GB, o texto começou a aparecer em cerca de 1 segundo e saiu a uns 7 tokens por segundo, pouco acima do ritmo de leitura. Um parágrafo costuma levar menos de um minuto.
Sim. Você baixa pelo painel de administração do Open WebUI ou por SSH, com docker exec ollama ollama pull seguido do nome do modelo. Modelos maiores exigem mais memória e respondem mais devagar.
Não. O modelo roda dentro do seu VPS e nenhuma mensagem é enviada para OpenAI, Google ou qualquer outro serviço. Os dados ficam no data center que você escolheu.
Pode, nos parâmetros avançados do modelo. Ele vem desligado porque, sem placa de vídeo, o raciocínio deixa cada resposta muito mais lenta.
A versão instalada é fixa, para que nenhuma atualização mude o comportamento sem aviso. Você atualiza quando quiser, pelo acesso root, depois de testar.
Use a opção de reinstalar no painel do VPS, na área do cliente, que apaga os dados do servidor. Se quiser o app instalado de novo, o suporte 24/7 em português ajuda pelo WhatsApp, ticket ou telefone.
Atualizado em 19 de outubro de 2026
 Open WebUIOpen WebUI é um chat de IA no estilo ChatGPT que fica no seu próprio servidor.
 n8nO n8n conecta aplicativos, APIs e modelos de IA em fluxos automáticos montados num editor visual.
 LangflowLangflow é um editor visual para montar agentes de IA, chatbots e fluxos de RAG, e cada fluxo pode ser chamado por API.
Diga o que quer rodar e quantos usuários; a gente indica o plano. O app chega instalado.